# DeepSeek 开源了自家推理引擎:单模型引擎为什么总能暴打通用引擎
Published: 2026-10-27 · Language: zh
Original: https://yage.ai/share/deepseek-deepinfer-single-model-engines-20261027.html
Publisher: Superlinear Academy · 100% AI generated
[Article index](https://yage.ai/share/llms.txt)
[Other language](https://yage.ai/share/deepseek-deepinfer-single-model-engines-en-20261027.html)
最近几天在公众号和科技媒体上看到了一个新闻,DeepSeek开源了自己的推理引擎[DeepInfer](https://github.com/deepseek-ai/DeepInfer),各个标题主要强调这个东西有多快。推理引擎是什么东西呢?它指的是让大模型可以运行的底层软件,包括接受我们的提问,并且给出相应的回答。我们调用 DeepSeek 的线上服务时,背后就是这套软件在提供服务。
如果你只是今天看到这个消息,想在几分钟内理解它跟自己有没有关系,我的结论是:对大多数人来说,它不需要直接使用。但这件事可以揭示一个更有用的规律:为什么这些专门为某个模型定制的引擎,往往看起来比 vLLM 这样的通用引擎更快;而真正把模型服务做好的系统层,并不在这次开源的代码里。
## DeepInfer 是什么,跟你有没有关系
想自己下载试试也行,运行门槛一目了然。DeepSeek 在10月20日发布的代码只支持Linux系统,也只支持DeepSeek-V4.1-Flash这一个模型。硬件上只支持英伟达B200、GB200这一代数据中心显卡和华为昇腾950数据中心芯片,不支持普通游戏显卡和Mac电脑。
即便你有数据中心显卡,也需要区分 DeepSeek 自己的线上部署和这次开源的内容。推理引擎分两步,第一步是把整个输入提示词读进来算出中间状态,叫读入;第二步是一个字一个字往外吐出答案,叫生成。[官方的部署问答](https://github.com/deepseek-ai/DeepInfer/blob/main/doc/inference_deployment_qa.md)说的是 DeepSeek 自己线上如何部署,把读入和生成分开在不同的卡上,建议的最小高效单元是 64 张卡读入 + 64 张卡生成,共 128 张卡。但这次开源的代码只提供离线批量推理,就是要把一批问题一次性喂进去、批量产出结果,不能装好就直接当在线服务用。线上那套分开部署的部分没有开源。所以真正可能直接用它的,是手里有一批新一代数据中心卡、又正好要离线跑这个模型的团队。
## 它到底快不快
新闻里面都说DeepInfer很快,但衡量推理引擎快慢有两个不同的指标,一个是总吞吐,看一批请求一起进来能多快吐完,决定机器的算力账单;另一个是首字延迟,看发出请求后要等多久才能见到第一个字,决定人的实际体感。日常觉得好不好用主要看首字延迟,但这两个指标经常打架。
目前只有一份同机第三方测试来自 [GPUStack 的同机对比](https://gpustack.ai/blog/deepinfer-vs-vllm-on-gpustack-8x-b200/)。因为开源版的 DeepInfer 只能离线批量跑,测试方为了和通用引擎 vLLM 比在线服务,得在外面包一层社区写的接口程序。他们在同一台八卡机器上跑同一个模型,发 100 个请求、16 路并发,每条输入 8192 个词元、输出 1024 个词元(词元就是模型处理文本的字词片段)。结果两个指标正好相反:DeepInfer 的总吞吐高了 25.2%,是每秒 1392 对 1112 个词元;但首字延迟约是 vLLM 的两倍,是 4.28 秒对 2.04 秒。这次测试里两边都关了一项常用的提速功能,且双方都没有做充分的调优。
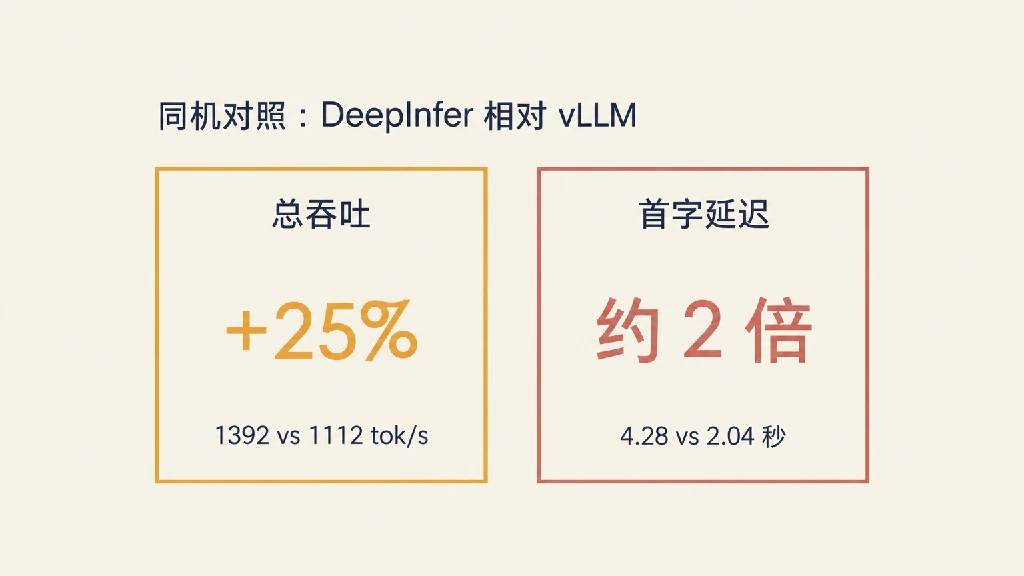 在同一台八卡机器上,DeepInfer 的总吞吐比 vLLM 高 25%,但首字延迟约是 vLLM 的两倍。
DeepInfer 开源后的三到四天里,两个通用引擎分别发了自己项目的自测报告。10月23日,[vLLM 发文](https://vllm.ai/blog/2026-10-23-deepseek-v41-flash-pd-wide-ep)说在 32 张同代数据中心卡上,每卡的生成吞吐和 DeepSeek 官方公布的性能曲线相差不超过 6%(不是同机同配置对比)。10月24 日,另一个通用引擎 [SGLang 发文](https://www.lmsys.org/blog/2026-10-24-dsv41-deepinfer/)说在与 DeepInfer 相同的硬件上用 DeepInfer 自带的测试,结果和 DeepInfer 基本持平、有些步骤还略快。
## 单模型引擎的快,多半不是引擎的功劳
GPUStack 那次测试里两边都关掉的那项提速功能,叫做投机解码。它的原理是先让一个小模块猜几个词,然后一个大模型一次性核对,如果猜对了就可以省几步。DeepInfer 只是一个例子,在 AI 社区里面我们经常看到工程师给某个模型专门写一个引擎,比如[面向英伟达游戏卡的 NInfer](https://github.com/Neroued/ninfer),[面向家用机的 Strata](https://github.com/Niko1221/Strata),[最初面向 Mac 的 ds4](https://github.com/antirez/ds4)。网上经常有人拿他们的数字说比 vLLM 快几倍。如果你想在本地部署模型,或者想看懂这类新闻,需要了解这种优势常见的三个来源。
第一是在某些硬件上装得下、跑得起来。比如 Strata 把不常用的参数放到内存里面,就可以用 12GB 的游戏卡加大内存来装约 1250 亿参数的模型。今年 5 月 ds4 发布的时候,通用的引擎 llama.cpp 还不支持 DeepSeek V4 Flash,但是一个多月以后 llama.cpp 就支持了。
第二是相关的权重包,即把同一个模型转换、压缩成某个引擎专用格式的文件。我对自己显卡用的同一个引擎,只换权重包(连同缓存的压缩格式),读入速度快了 13% 到 46%;只升级引擎版本,读入只快 1% 到 5%。换权重包的提速比升级引擎版本大一个量级。
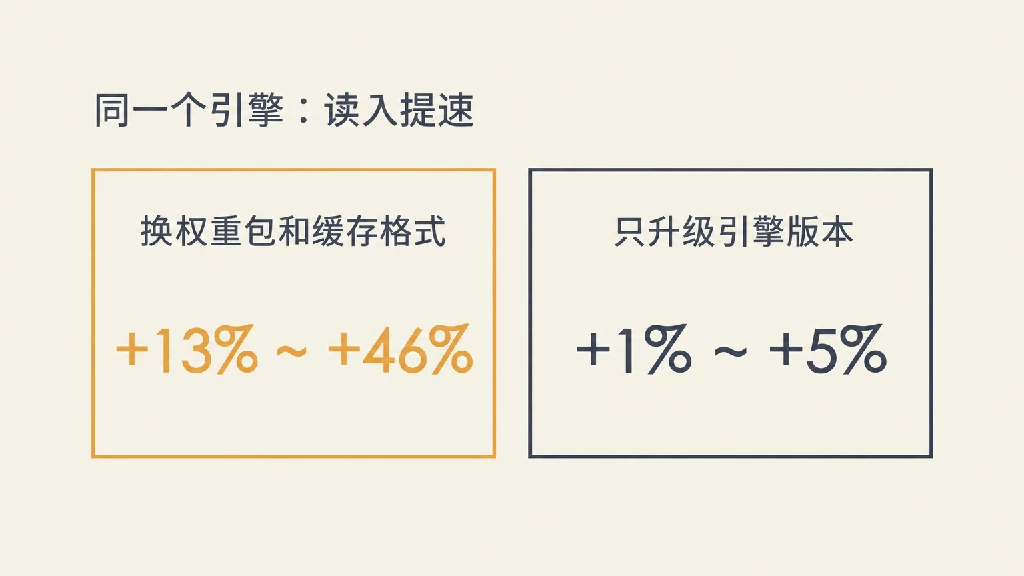 同一个引擎只换权重包(连同缓存格式),读入快 13% 到 46%;只升级引擎版本,读入只快 1% 到 5%。
第三是投机解码。通用引擎 SGLang 的正式版曾经缺少一个关键组件,我机器上一个请求每秒约 90 个词元;合入[补齐它的改动](https://github.com/sgl-project/sglang/pull/35496)后,跑数学和代码题到了约 230,这个改动两周多后进了正式版。单模型引擎领先的那一段,往往是这种时间差。我机器上这几组数字的测试条件不完全一样,只能看个大概。
## 真正难的那一层,DeepSeek 没开源
引擎层的提速不久就会被通用框架追上,那 DeepSeek 线上服务最难复制的部分在哪?官方在社交媒体上的说法是完全开源的生产系统,但看 [DeepInfer 的说明文档](https://github.com/deepseek-ai/DeepInfer),它明确列出了没有开源的三块内容。第一块是长期保存、跨机器复用中间结果的缓存系统。第二块是把读入和生成放到不同机器上的分离部署,代码里对应函数在基类中是空的。第三块是在多个服务副本之间分配请求。官方说是和内部基础设施耦合太紧,暂未完整开源。
一个直观的例子是,编程助手每轮都会把长历史发给模型,引擎用缓存上一轮的中间结果来省掉重读。我有一次用编程助手跑长会话,它超了上下文上限被拒,随即改写了中间的历史,缓存对不上,那一轮等了 24 秒才出第一个字;下一轮缓存重新建好,不到 0.3 秒。缓存和路由系统要处理的正是这类问题:让请求尽量命中缓存,并把请求派到存着它缓存的机器上。DeepInfer 恰好没开源这一块。
我在10月写过[自建多卡路由为什么难](https://yage.ai/share/selfhost-multi-gpu-routing-20261016.html),核心矛盾在于缓存复用要把会话固定在一张卡上,缩短排队又要把请求分散,两者冲突。这里可以做一个推断:引擎层面的优化迟早会被通用框架追上,真正和自家基础设施绑在一起的,可能是这套没有开源的缓存和路由系统。
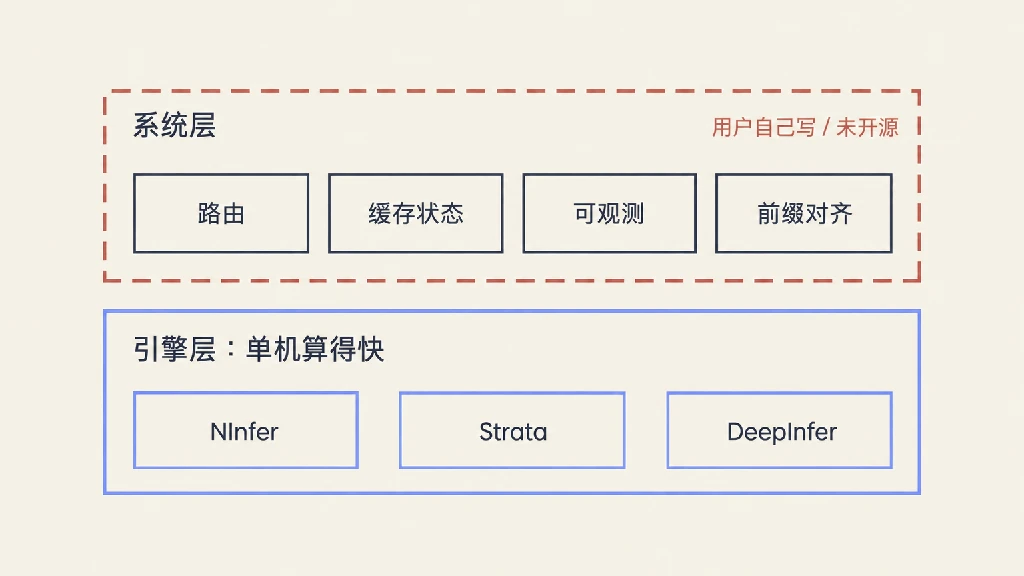 NInfer、Strata、DeepInfer 都把力气花在单机算得快的引擎层,派请求、管缓存这一层要么由用户自己写,要么没有开源。
## 下次再看到这类新闻,可以问三个问题
因此下次你看到一个新引擎比 vLLM 快几倍,或大厂开源了一个新的推理框架,先别急着看跑分图,想想这三个问题,脉络就清了。第一,它指的是哪种快,是谁在什么条件下测的,总吞吐高只说明批量处理划算,不代表你等第一个字的时间更短。第二,这个优势来自引擎本身,还是来自装得下、权重包、投机解码,如果是投机解码或新模型支持,通用引擎往往几周到一两个月内就会追近。第三,它开源的是哪一层,单机引擎开源不等于整套服务开源,跨机器缓存和请求路由才是自建服务最费劲的部分。
我在今年7月写过[关于vLLM和特化推理的文章](https://yage.ai/share/vllm-tilert-specialized-inference-paths-20260717.html),结尾曾经问过一个问题:这类专门定制的推理引擎会长期独立存在,还是最终会被通用引擎吸收?看完这几个月从社区项目到DeepInfer的演变,我现在的回答是:投机解码这类提速上的领先会被通用引擎吸收,对新模型的支持也会在一两个月内跟上,但缓存和路由这一层不会自动跟过来。