# 比顶配便宜却跑分反超:从刚上线的 Gemini 4 Neon,看 Google 怎么跑通单会话双模型接力
Published: 2026-11-19 · Language: zh
Original: https://yage.ai/share/gemini-4-neon-orchestrator-20261119.html
Publisher: Superlinear Academy · 100% AI generated
[Article index](https://yage.ai/share/llms.txt)
[Other language](https://yage.ai/share/gemini-4-neon-orchestrator-en-20261119.html)
日常使用大模型进行代码编写或执行几十轮编程智能体的过程中,一个主要挑战是如何在保证质量的同时尽可能降低成本。之前有两家大厂提出了不同的解决方案。Anthropic(Claude 的开发商)在[之前读过的官方省钱指南](https://yage.ai/share/effort-vs-model-tiering-20261012.html)里提出,在同一个会话中始终使用同一个高质量的模型,同时降低其思考的档位,借此减少模型在生成答案前进行的内部推理步骤来省钱。而 DeepSeek 在[此前分析过的常驻编程代理](https://yage.ai/share/deepseek-superagent-pm-patches-20261106.html)里用项目经理和子代理两层来实现分工,但这两层代理都需要重新阅读上下文,因此产生了 3.8 倍的重复读取开销。
然而最近五周 Google 一口气推出了四个新一代模型。他们在 2026 年 11 月 18 日发布了第四个模型 `Gemini 4 Neon`,同时在自家的编程工具 Antigravity 中引入了 `Orchestrator (Neon)` 这种双模型调度模式。这个中等价位的新模型在测试中超过了即将恢复原价的旗舰模型 Carbon,同时为主流付费订阅提供了单会话双模型接力机制。把这三家公司对比一下,就可以看出编程智能体省钱的第三条路径。
## 定价低四分之一、跑分反而压过顶配,刚上线的 Neon 到底是什么来头?
先看价格。Google 最早发的 Argon 和顶配 Carbon 现在都在半价促销,到了 12 月 1 日,两款都会翻倍涨回同样的原价:每百万 `token` 输入 4 美元、输出 20 美元(模型内部的思考过程也按更贵的输出算)。原价一样,能力更强的 Carbon 一上来就把 Argon 衬得没法选了;更要命的是,前几天出的平价模型 Hydrogen 自带免费档,付费价不到顶配四成,跑分却直接超了 Argon。上下夹击之下,同步更新的 [Gemini 官方选型指南](https://aistudio.google.com/docs/choosing-a-model) 干脆把 Argon 从推荐主表里拿掉了。
接替主力位置的 Neon 没有促销期,直接给出每百万 `token` 输入 3 美元、输出 15 美元的固定挂牌价,比顶配原价低四分之一。很多人起初以为它只是填补价格空档的次旗舰,看了刚发布的 [Neon 官方模型卡](https://storage.googleapis.com/deepmind-media/Model-Cards/Gemini-4-Neon-Model-Card.pdf) 才发现,它直接改自顶配 Carbon,在后训练里重点强化了编程智能体表现,写代码时偷懒走捷径的比例也压到了全系最低。
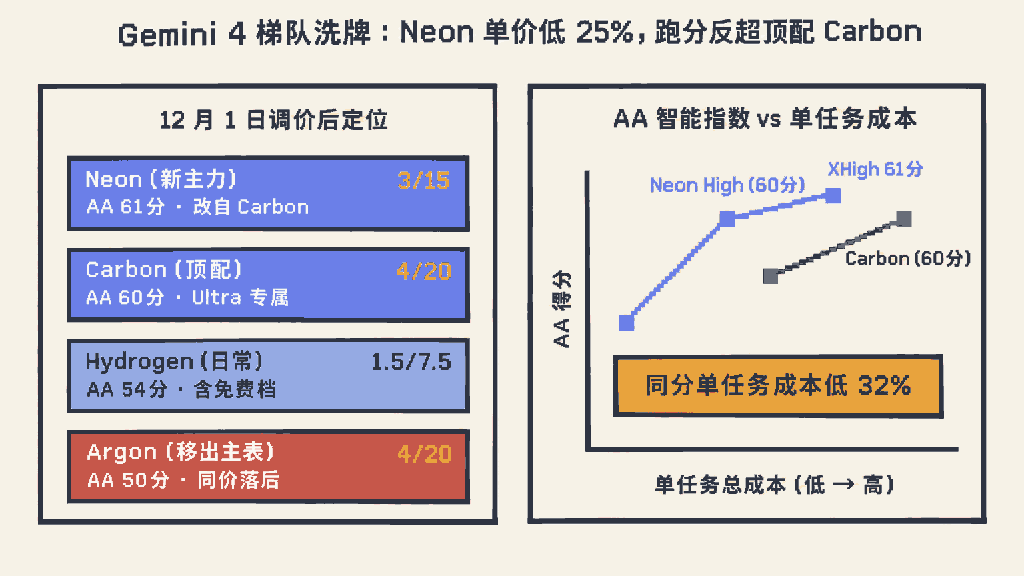 恢复原价后,改自 Carbon 的 Gemini 4 Neon 以更低单价在综合智能指数和单任务成本上反超顶配 Carbon,并替代 Argon 成为新主力。
在 [Neon 官方发布博客](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/) 披露的独立评测里,它直接在综合榜单上实现了反超。Artificial Analysis 综合智能指数上,Neon 最高思考档位 `xhigh` 拿到 61 分,压过了 60 分的顶配 Carbon;用默认高档 `high` 就能打平顶配,单任务总成本比 Carbon 低 32%,同时夺得编码智能体榜单全球第一。这让 Neon 顺理成章接替刚满月的 Argon 成为推荐主力,并在 Antigravity 中置顶成为新会话的默认模型,更贵的 Carbon 退居高价 Ultra 订阅专攻极长程科研难题,日常高频的轻量开发则交给自带免费档的 Hydrogen 去跑。
## Anthropic 劝死守单模型、DeepSeek 拆双层多烧缓存,Google 靠什么在单会话里跑通双模型接力?
有了不同能力的模型之后,一个直觉的想法是用强模型来指引方向,用便宜的模型来写代码。但这在工程上会碰到两个挑战,一个是缓存失效,一个是交接失灵。编程智能体每一步都会把之前的对话历史和工具说明重贴一遍。服务器会把已经算过的重复前缀存下来打折,也就是前缀缓存。但前缀缓存是绑在某个具体模型上的,不同的模型不能共享。
Anthropic 在 [官方成本与智能优化指南](https://platform.claude.com/docs/en/about-claude/models/optimizing-for-cost-and-intelligence) 里统计了很多团队的数据,发现编程循环里近九成输入都靠前缀缓存省钱。但在 Anthropic 里,第一次把历史放进缓存要付 25% 的写入溢价,如果中途换模型,以前攒的缓存直接作废,新模型又要重交写入溢价,省下来的单价反而补不上。全程用便宜模型写码、实在不行再找强模型做顾问呢?Anthropic 做了近 400 次实验,没看见便宜模型主动问过一次,因为小模型根本不知道自己卡住了。所以 Anthropic 建议死守同一个强模型,通过调低思考档位来省钱。
但反手用一个强模型在同一个窗口里指挥、只把大任务分包给子代理,也会翻车。DeepSeek 测试常驻编程代理时发现,只要提示词留了可以顺手做的小事,5 轮里有 1 轮主模型会管不住手亲自下场写代码,把对话窗口锁死近半小时。为此 DeepSeek 把系统拆成两个独立会话,直接没收项目经理写代码的工具,只让它给后台子代理发工单。这虽然治好了手痒,但两边都要分别重读代码库和对话记录,平白多花了近四倍的缓存 `token`。
单模型太贵、拆双层又费缓存,Google 选的第三条路是在同一条会话里直接交棒。以前大家不敢中途换模型,除了怕缓存作废,更怕思路断掉:便宜模型只看到几行结论,很容易改偏。按照 [Gemini 思考机制文档](https://aistudio.google.com/docs/thinking),Gemini 4 每轮回答前会把内部推演打包成一段推理签名存在后台。切给便宜模型时,后台自动把这份签名接过去,接手的模型能直接顺着上一棒的思路接着干。
那为什么 Anthropic 劝大家别中途换模型,Google 这里却划算了?跨模型不能共享缓存这一点两家一样,换模型的那一轮,新模型都得按原价重读一遍上下文。差别在于交棒的代价和后续的回报。Anthropic 写缓存要多收 25% 的写入费,在一个已经聊长的会话中途换模型,重读加写入的成本一下就把差价吃掉了。Google 这边用隐式缓存,输入满门槛自动打 95% 折扣,而且不收写入费,切模型的过路费低得多。更重要的是交棒时机:`Orchestrator (Neon)` 趁开局刚做完规划、上下文还短的时候就早早交给 Hydrogen。接下来十几轮写代码、跑测试,大头开销其实在模型输出上(输出单价是输入的 5 倍,Hydrogen 输出只有 Neon 的一半),而且每轮重复输入都命中 Hydrogen 自己的缓存。趁开局短的时候交一次小过路费,换后面十几轮输出直接打对折,自然就划算了。
有了这套底层接口,Google 在 [Antigravity 模型和调度文档](https://antigravity.google/docs/models#orchestrator) 中推出了 `Orchestrator (Neon)`,让两个模型可以在同一轮回复里接力。每次收到需求,先让 Neon 进入只读模式探索代码库、写出计划并定下何时需要重规划;计划定好,系统在同一会话里交棒给便宜的 Hydrogen 改代码、跑测试;执行期间如果测试连续失败两次、接口行为与预期不符,或撞上未拍板的设计分支,控制权就自动弹回 Neon 查现场修计划,再交回 Hydrogen 继续跑。上周 Google 先推出了顶配 Carbon 搭档 Hydrogen 的编排模式,根据 [Antigravity 官方博客](https://antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity) 披露的编程基准实测,这套双模型接力的成功率已接近单跑顶配,平均省了 24% 额度、提速近两成。如今把更便宜的 Neon 接进来做成 `Orchestrator (Neon)`,就从高价 Ultra 档下放到了主流付费 Pro 订阅。
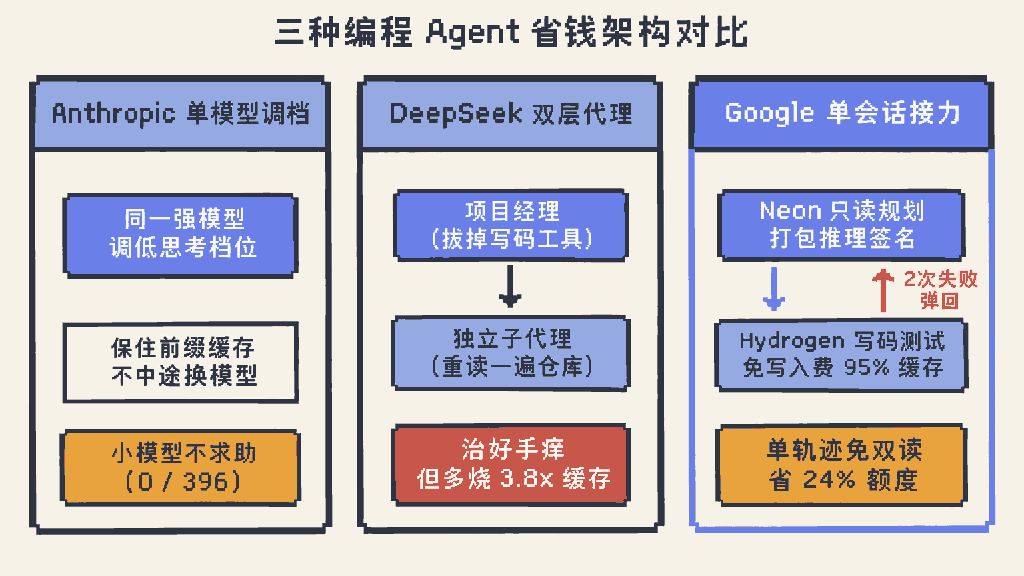 Anthropic 靠单模型降档保缓存,DeepSeek 靠双层隔离治手痒但多烧 3.8 倍缓存,Google 的 Orchestrator 则在同一条会话里用只读规划和两次失败回弹实现双模型接力。
## 为什么一换小模型就得补规矩:从结果确定性退回过程确定性的必然
如果暂时不论缓存折扣、接口参数等细节,这三个厂商的技术路线差异,本质上反映了智能体工程中两种不同的控制哲学。我在之前的文章《[从过程确定性到结果确定性](https://yage.ai/result-certainty.html)》中比较过这两种确定性。结果确定性是不规定具体的每一步怎么做,只明确最终验收标准,通过模型的推理、观察和纠错来达到目标;过程确定性则是在流程的阶段、工具权限和外部触发条件等方面对过程进行强约束。前者强调模型的自由裁量权,后者则强调通过流程护栏保证可靠性。
这两种思路哪个更好,取决于你用的模型是否足够聪明。对于 Anthropic 这种指令跟随好、判断力强的旗舰模型,采用单模型的结果确定性是合理的。只要把目标明确说明,它自己就知道什么时候需要查代码、什么时候需要调整策略,不需要额外的流程。但在成本压力下改用小模型,或者在单窗口里用提示词来区分不同角色,小模型往往不能可靠地跟随隐含的指令,甚至不知道自己卡住了,Anthropic 在近 400 次实验里都没有看到它主动求助。同时 DeepSeek 也观察到,哪怕是强模型,在单窗口里看到写代码的工具时,也不一定能克制住自己写代码的冲动。这时候就需要用过程确定性从外部兜底约束。
DeepSeek 和 Google 都加入了过程确定性的设计,只是强度不同。DeepSeek 通过物理拆分两个会话加上直接取消项目经理写码工具来提供较强的过程确定性,让主模型根本不会去尝试写码,但代价是两个会话分别重读仓库,额外消耗了 3.8 倍的缓存。Google 的 `Orchestrator (Neon)` 同样提供了过程确定性,但把它做得更轻量,放在同一个会话里:在规划期给强模型只读权限防止手痒,在实施期用测试连续失败两次这种外部明确信号把失控的小模型弹回强模型。用最轻的过程确定性兜住小模型的下限,同时保留单会话的上下文和缓存连续性,这是双模型接力有效协作的关键。
## 手头正在跑的 Agent 工作流,现在怎么选档、怎么抄作业?
如果你直接用 Antigravity 写码,日常开发、修 bug 和跨文件重构直接选 `Orchestrator (Neon)` 就好,唯一要注意它的内部配比固定,不能手动调节思考档位。只是改小脚本、升级依赖或补单测,直选带免费档的 Hydrogen 更快;真遇到每一步都要深度推演的复杂系统设计,再直选 Neon 开 `high` 档或 `xhigh` 档。
如果你自己调接口搭智能体,可以在月底恢复原价前把旧的 Argon 配置改成 Neon 加 Hydrogen。与此同时,可以直接套用官方编排器的两条轻量规矩:一是在规划阶段锁只读工具,逼强模型只定方案和异常触发条件,不顺手写大段模板代码;二是不指望小模型自觉求助,改用测试验证连续失败两次这类明确信号,强制切回强模型重编计划。
在投入生产之前,有两点需要注意。第一点是 Neon 刚刚发布,官方和合作榜单以外并没有长期检验,对于超长对话或者冷门代码库的真实口碑,还需要在社区运行几周后才能沉淀出来。第二点是如果某些极难任务还是需要调用 Carbon,需要提防线上延迟波动。根据转发平台 [OrcaRouter 的生产监测](https://www.orcarouter.ai/blog/gemini-4-release-date) 显示,过去一周 Carbon 有一半的请求需要等待 10 秒以上才吐出第一个字,接近四分之一直接报错。官方也建议把复杂请求的超时设到至少 15 分钟或者放后台跑。在代码中先把长超时和报错重试配齐,再去切这个双模型流水线心里更有底。