# 报告称 DeepSeek-V4-Flash 用上 NVIDIA 禁运显卡:AI 硬件侧信道的三种路径
Published: 2026-11-18 · Language: zh
Original: https://yage.ai/share/gpu-side-channel-forensics-20261118.html
Publisher: Superlinear Academy · 100% AI generated
[Article index](https://yage.ai/share/llms.txt)
[Other language](https://yage.ai/share/gpu-side-channel-forensics-en-20261118.html)
11 月中旬,[Unemployment Labs 发布报告](https://unemploymentlabs.com/checkpoint-forensics),指出他们仅凭公开下载的模型权重,就推断出 DeepSeek-V4-Flash、Kimi K3 等六款中国新模型在初始化阶段用到了受美国出口管制限制的 NVIDIA Blackwell 显卡。由于这一代芯片属于对华禁运硬件,这份报告很快在业内引发关注。
撇开合规争议,这项研究真正有意思的是背后的取证逻辑:模型训练完、权重文件公开发布之后,里面怎么还会留着显卡型号的痕迹?把视角再放大一点,从最初生成权重、低精度训练到最后上线提供推理服务,硬件的物理特性在每一步都有机会透进数据或输出里。下面先讲清楚这份报告是怎么从权重里读出显卡型号的,再顺着模型生命周期看看另外两条侧信道,以及它们眼下的实际成色和防堵成本。
## 训练结束后,权重里为什么还留着初始显卡的痕迹?
训练开始前,PyTorch 会把整张权重矩阵当成一条有几亿个格子的长带子,调用 NVIDIA 的 Philox 算法往里面填满随机初始值。为了填得快,显卡上的所有并行计算单元 SM 会一起开工,每个 SM 固定派出一支两千多人的施工小队。不同显卡的 SM 数量不同:H100 有 132 个 SM,全场一共约 27 万名工人同时上阵;B200 有 148 个 SM,GB200 有 152 个 SM,全场总人数分别增加到约 30 万和 31 万。
给定同一颗随机种子,每条线程自己生成的数字序列完全固定:无论在哪张卡上,同一编号的线程算出的第 1 个数、第 2 个数都一模一样。但往权重矩阵里填数时,全场所有线程是按编号轮流一格一格往下填的。看下面这张 3 行 4 列的简化示意图就明白了:左边的小显卡假设只有 A、B、C 三条线程轮流填,前 3 格填完第一轮,第 4 格就立刻轮到线程 A 填第二轮的数,一路顺延下来,最底下那一行填进去了 `C3, A4, B4, C4`。右边换一张大显卡,多了一条线程 D,变成四条线程轮流填,正好每行 4 格填满一轮,最底下那一行填进去的就变成了 `A3, B3, C3, D3`。
明明随机种子一模一样,每条线程各自生成的数字也没变,可仅仅因为参与轮流填表的线程总数变了,每一轮的跨度不同,越往后的行错位就越远。在真实模型里,面对第几亿个格子,H100 和 B200 填进同一行里的,早就变成了完全不同线程在不同轮次生成的数字。
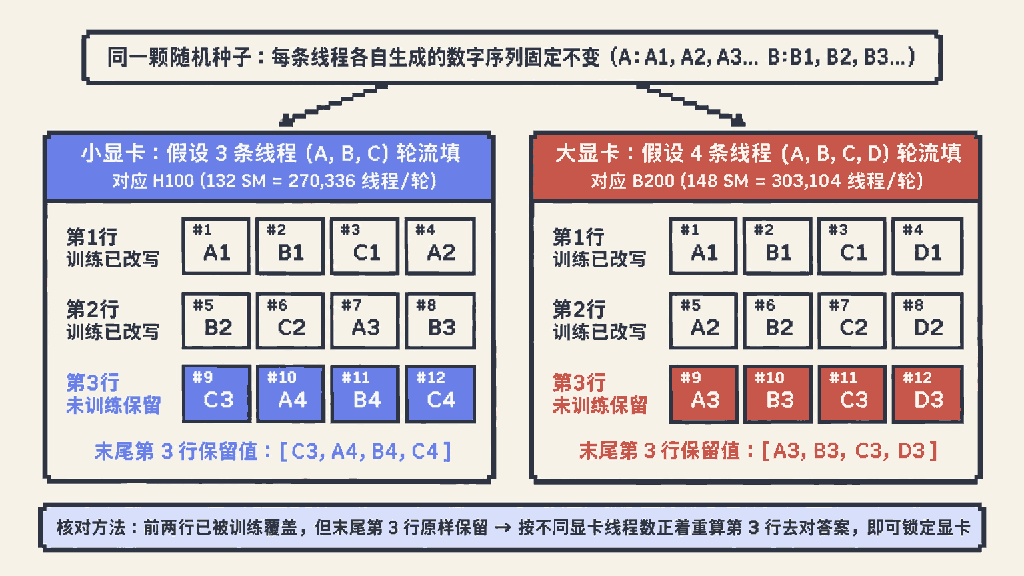 同一随机种子在 H100 与 B200 上写入权重矩阵的坐标差异
那为什么最底下那一行能保留到训练结束?这跟词表矩阵的更新方式有关。神经网络中间层的参数是每读一句话就全员一起更新,唯独开头的词表矩阵是按词对号入座的:训练语料里实际出现了哪个词,才只更新那个词对应的那一行;只要某个词从头到尾没出现过,它那一行参数就纹丝不动。而在真实大模型里,总有一批行一次都不会出现:既有预训练语料里没撞上的极冷门符号、或是专门留给后续对话微调的预留标记,也有工程师为了让矩阵行数凑够 128 的整数倍、在词表末尾顺手补出来的几百个凑整空行。这些行里的数字从头到尾没有更新过,原封不动保留着初始化时的状态,而且它们排在词表第几行、对应第几个格子,打开公开下载的权重文件直接就能看到。
既然知道末尾未训练行的确切位置,外部研究者就不用去反推打乱的顺序,直接正着重算一遍去对答案就行:先假定一颗随机种子,再分别按 H100 和 B200 的线程总数与轮流规则,直接算出末尾未训练行那个位置该填哪些数,拿去跟下载的权重文件比对。因为 PyTorch 默认的随机种子总共只有约 43 亿种可能,研究团队直接用穷举法把全部种子和常见显卡线程数试了一遍,累计核查约 6 万亿种组合。只要种子或显卡型号猜错,算出来的数就跟文件里的未训练行毫无关系;一旦两者同时猜中,整行几千个数字就会逐位对上,相关系数超过 0.999。
靠这套办法,他们在 DeepSeek-V4-Flash、Kimi K3 和 MiniMax-M3 等六款中国新模型里匹配出 Blackwell 排布,而更早的 DeepSeek-V3 和同期的 GLM-5 等则对应上一代 Hopper。为了验证结果,团队真机租用了 H100 和 GB200,现场重算出与 DeepSeek-V3 及 Kimi K3 完全一致的未用行。他们还专门比对了 AMD MI300X 显卡的计算单元排布,确认 DeepSeek-V4-Flash 的特征只指向 NVIDIA,随后把[复现代码](https://github.com/macrogrants/checkpoint-forensics)全部开源。
一天后,开发者 Bojie Li 发布了[独立复现报告](https://01.me/2026/11/checkpoint-forensics/)与[扩展扫描工具](https://github.com/bojieli/checkpoint-forensics)。他在两百多个开源模型里找出了 185 个硬件线程指纹,除了中国模型,也涵盖 NVIDIA Nemotron 等海外型号。
那如果词表里没留原封不动的空位,是不是就查不出来了?未必。在小米 MiMo-V2.5-Pro-Base 里,词表每一行都参与了训练,最终权重等于初始随机数加上训练改变量。因为训练改变量远大于初始值,单拿任何一行去和初始序列比对,相似度都微乎其微;可一旦把上万行数据放在一起同时比对,不同词的训练改变量方向各异、在统计上互相抵消,唯独真正的初始序列能在每一行里都贡献一点正向吻合,累积起来就能把 Hopper 排布清晰地凸现出来。还有一种常见情况是训练开启了权重衰减:算法每走一步,都会给所有参数乘上一个略小于一的正数,让数值整体往零缩小。在 Qwen2-7B 里,那些没参与训练的空位行一路缩到了存储格式能表示的最小非零值,所有数字的绝对值全都变得一样;但因为每次只是乘以正数,正负号从来没有翻转过,光靠核对整行加减号的排列顺序,依然能把 Hopper 的初始序列锁定出来。
当然,这套方法也有明确的技术边界。它只能看清生成初始权重那一刻用了什么规格的显卡,而且只要两款显卡的 SM 数量相同,全场总人数就一样,单靠排布无法进一步区分。至于初始化完成之后,漫长的正式训练有没有一直留在同款显卡上,静态权重本身给不出直接证明,因为中途随时可以把权重存盘、挪到别的集群继续训练。
## 改用 CPU 初始化就会失效,静态权重里还有别的线索吗?
初始化指纹虽然查得准,但厂商想要抹掉它并不难。在 Bojie Li 扫描的模型里,就有几十个模型读不出这套指纹:有的直接用 CPU 单线程顺序生成初始权重,有的在训练结束后用 CPU 随机数覆盖了词表末尾的空位,还有像 DeepSeek-V4.1-Flash 这样虽然留着看似未动的空位行,却对不上已知显卡排布和随机种子,多半是更换了初始化代码。只要避开显卡默认的并行初始化流程,前一条线索就会彻底断掉。
如果初始化改到了 CPU 上,训练出来的权重里还会留下显卡自己的算术痕迹吗?理论上还有一条线索,来自低精度训练的分组缩放方式。为了省显存、提速度,现在训练大模型常把高精度参数压缩成 8 比特甚至 4 比特的低精度格式。4 比特除去正负号,本身只能表示零点五、一、一点五、二、三、四、六等寥寥几个固定刻度;要想拿它装下大小悬殊的真实权重,工程上必须把相邻的权重分成小队,给每个小队配一个共同的缩放倍率,让队里所有数字都表示成这个倍率乘以上述固定刻度。根据 [NVIDIA 的技术介绍](https://developer.nvidia.com/blog/introducing-nvfp4-for-efficient-and-accurate-low-precision-inference/),上一代 Hopper 主推的 8 比特格式,通常按上百个参数甚至整张矩阵共用一个倍率;而新一代 Blackwell 原生支持的 4 比特格式,硬件规定每 16 个相邻参数就得单独配一个倍率。
这种硬件格式差异为什么可能留痕?因为在同一个小队内部,所有数字都是同一个倍率乘以那几个固定刻度算出来的,彼此之间的比值落在同一套网格上;一旦跨进下一小队,倍率就会重新换一套。理论上,检测权重矩阵里是不是每 16 个元素就出现一次倍率切换,就能分辨出底层是不是跑在 Blackwell 的原生低精度硬件流水线上。不过这条路眼下还停留在原理推演阶段:模型预训练完通常还要经历高精度微调与强化学习,发布前也会转回常规格式重新打包,后续的连续数值改动会把原本整齐的网格冲淡,目前社区也还没有做出能跨大批量模型稳定提取这种信号的开源工具。
## 只开在线 API 时,还能试探出推理机房的显卡吗?
前面两条路都得先拿到公开的权重文件,查的是模型出厂前用过什么卡。如果模型已经上线,只对外提供一个黑盒聊天接口,既不透露机房里插了什么卡,也不公开后台跑的推理软件和量化精度,外部还能试探出底细吗?这要看接口背后跑的模型本身有没有开源权重,测试思路分成两路。
第一路是云厂商托管开源模型这类已知权重的情况。就算拿不到后台权限,大模型的吐字结果本身也会暴露底层硬件的算术差异。计算机做浮点数加法时,先加前两个数还是先加后两个数,末尾最后一位会出现细微的舍入差异;[Thinking Machines Lab 的技术分析](https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/)就曾演示过,哪怕把采样温度设为零、彻底关掉随机抽签,仅仅因为服务端并行求和的先后顺序微调,算出来的候选词得分就会在小数点后好几位发生轻微漂移。
不同代际的显卡和不同的推理软件,在切分矩阵乘法和并行汇总求和时,采用的归约顺序各有固定套路。平时小数点后几位的差别不会影响哪个词排第一;可一旦碰上两个候选词得分咬得极紧,最后一位的舍入差异就足以让冠亚军互换,改写模型吐出的下一个字,并在后续生成里一路放大。NeurIPS 论文[《大语言模型推理系统指纹识别》](https://arxiv.org/abs/2605.29979)正是利用这一点:测试者先用本地的开源权重筛选出一批特殊提问,故意制造两个候选词得分几乎打平的临界场面,再把这些提问发给线上接口,看它每次偏向哪个词,就能反推出后台的软硬件组合。在论文的测试基准里,把采样温度设为零时,这套提问探针识别底层显卡型号、推理引擎和注意力计算后端的准确率达到了百分之百;就算把温度调到 0.3 引入随机采样,多测几次后识别显卡型号与推理引擎的平均准确率依然接近八成。由于想堵住这条路就得把不同芯片和软件栈的底层浮点运算对齐到一字不差,工程上防起来相当棘手。
第二路则是连权重都不公开的纯闭源接口。没法在本地预筛临界提问,外部就只能从吐字速度上摸硬件的物理天花板。大模型逐字生成回答时,每蹦出一个新字,都得把参与计算的模型权重从显存搬进计算单元重读一遍,所以吐字快慢直接受限于显存每秒能搬运多少数据。以机房主力的高带宽 SXM 规格为例,上一代 H100 的显存带宽是 3.35 TB/s,新一代 B200 则跃升到了 8.0 TB/s,达到前者的两倍多;与此同时,如果后台把权重精度压缩一半,每生成一个字需要搬运的数据量减半,吐字速度同样会大幅加快。
这也决定了单纯测速的局限性:面对既不公布参数规模、也不透露压缩方案的闭源服务,外部单看吐字变快,没法直接断定是机房换上了带宽翻倍的新显卡,还是工程师把模型压得更轻了。黑盒测速真正量出来的,其实是显存带宽上限与权重压缩程度共同划出的一道性能边界。
## 三条路径的信号强度与绕过代价
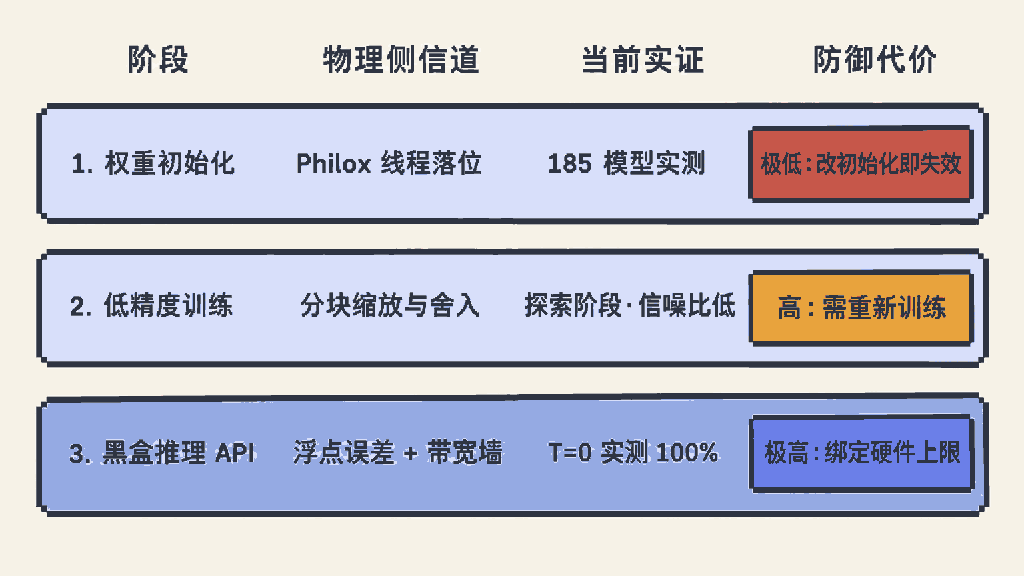 模型生命周期三条硬件侧信道在实证力度与防御代价上的对比
顺着模型从出厂到上线的全流程盘点下来,这三条路径的证据强度和防堵成本恰好形成鲜明反差。Philox 初始化排布已经在 185 个开源模型上验出了确凿指纹,是目前实证最扎实的一条路;但它的防堵成本也最低,厂商只要改用 CPU 初始化,或者在训练结束后把词表空位覆盖掉,这条线索就会立刻失效。
低精度训练的分组缩放痕迹绑在显卡原生的算术格式上,哪怕换用 CPU 初始化也绕不开。不过它目前还停留在机制推演阶段,后续的高精度微调与格式转换都会冲淡这种周期性网格,社区里也还没有出现经过大规模跨模型验证的检测工具。
真正能直接试探线上黑盒服务的,是推理阶段的算术分歧与速度边界。对于托管开源权重的接口,利用临界提问放大底层浮点加法差异,已经在实验里拿下了很高的软硬件识别率,而且极难在工程上彻底抹平;对于完全闭源的接口,吐字测速虽然点不出具体显卡的名字,却依然能摸到显存带宽与量化压缩共同决定的物理上限。软件工程向来擅长用抽象层把底层硬件藏在幕后,但在大模型密集并行与低精度算术的放大镜下,机房里的芯片依然会在权重矩阵和接口响应里留下自己的印记。