# 不用额外埋点,如何用手头的本地日志给 AI 工具做降智尸检
Published: 2026-11-17 · Language: zh
Original: https://yage.ai/share/local-log-forensics-ai-degradation-20261117.html
Publisher: Superlinear Academy · 100% AI generated
[Article index](https://yage.ai/share/llms.txt)
[Other language](https://yage.ai/share/local-log-forensics-ai-degradation-en-20261117.html)
每天高强度使用 Claude Code、Cursor 或 OpenCode 等工具的码农可能都有过这样的体验:前一天还在享受能够进行跨文件重构的智能编程助手的快感,第二天早上就发现 AI 开始说胡话,不仅无视项目的要求,甚至完全不看目标文件就大段修改。这时候去看官方的状态页面一片全绿,网上最新的模型跑分榜也是风平浪静。这到底是谁的问题?是厂商偷偷降低了配置?还是我改坏了本地的提示词和配置?
为什么公开的跑分榜看不到这种日常退化,其实是有明确的机制原因的。从 2026 年 10 月下旬开始,很多 Claude Opus 5.5 的重度用户开始抱怨 Opus 5.5 经常无视指令。但是如果你访问 [LiveNerf 的每日评测项目](https://github.com/ninjahawk/livenerf)的话,可以看到这个连续测了 50 多天的公开监测站依然显示各项得分平稳如初。这主要是因为它受制于订阅配额,每天最多只能测 78 道题目。作者上线前实测发现,即使后台真的直接把 Opus 5.5 换成了上一代旧模型 Opus 5,这套题测出来的分数差距也在正常误差范围内,并不会触发警报。要想看到 2 个百分点的准确率波动,每周需要消耗将近一半的订阅额度。此外,它为了控制变量,特意在没有任何文件且禁用一切工具的空目录里考单轮做题,自然测不出多轮工具调用里的失常。
幸运的是,我们并不需要为此自购题库或预先部署监控插件。只要你的编程工具在本地硬盘中自动留存了 `.jsonl` 格式的本地会话日志,例如保存在 `~/.claude/projects/` 目录中的历史文本记录,里面就已经完整记录了每一轮对话的提问、模型回答、工具调用和账单明细。今年春天 AMD AI 总监 Stella Laurenzo 发布的 [4 月本地日志审计报告](https://github.com/anthropics/claude-code/issues/42796),以及近期一位重度订阅用户撰写的 [10 月本地日志审计报告](https://github.com/anthropics/claude-code/issues/105112),相继演示了一种零成本的取证思路。我们直接盘点手头现成的历史记录,就能把模糊的体感变成精确到小时的证据,还能指导手头的日常开发如何避坑。
## 怎么证明不是我改坏了自己的配置?
怀疑模型突然变差了,首先应该排查的是不是自己这边变了。可能是自己升级了软件版本、修改了全局指令文件,或者不小心污染了项目的上下文环境。为了洗脱自己的嫌疑,我们可以直接查看本地会话日志账单明细中的缓存命中 token 数,这个数值记录了本次请求直接复用了多少历史前缀。
服务端对缓存复用的校验非常严格,要求系统提示词、工具定义列表和项目规则文件必须完全一致,哪怕改动一个标点符号,前缀缓存就会失效重算。因此,这个数值天生就是检验本地环境是否变动的铅封。在 10 月下旬的审计中,作者检查了跨越异常时间窗口的 43 个新会话。日志显示,这些会话全都运行在同一个客户端版本上,而且每个新会话的首次请求命中的缓存 token 数,每一个都精确等于 29,503。这说明本地的系统提示词、工具定义和项目规范纹丝未动,变化百分之百来自云端。观察这个数字最大的用处,是让你立刻管住手,不要随意修改自己的全局提示词和项目规范文件。毕竟乱改本地配置不仅治不好云端的毛病,还会亲手打碎那九成以上的历史缓存复用,让你的订阅配额以十几倍的速度白白蒸发。
排除了本地配置变动之后,我们还可以用日志里的另一个元数据来探查云端隐藏的推理深度。模型在正式回答前会生成一段内部推演的思考块,服务端还会在思考块后面附上一个用于校验的加密签名。今年 3 月初,官方把默认接口里的思考块明文改成了隐藏状态,用户没法直接统计模型到底想了多少字,官方同时声称这一改动不影响模型的实际推理深度。
但是,加密签名仍然保存在本地日志中,且其字符长度与隐藏的思考文本的长度成正比。Stella 通过对比隐藏措施生效前的七千多个历史样本,发现了思考块附带的加密签名长度和实际思考字数之间存在 0.971 的高线性相关性。她用这个指标来测量这段时间的日志,发现模型的实际思考深度下降了 67%,并且在美西时间下午 5 点和晚上 7 点的用网高峰期出现了按小时规律性出现的降配谷底。在掌握了这个规律以后,平时遇到复杂的跨模块重构任务,就可以知道应该避开美西时间晚高峰,或者手动锁定最高的推理预算,避免在算力低谷期盲目死磕。
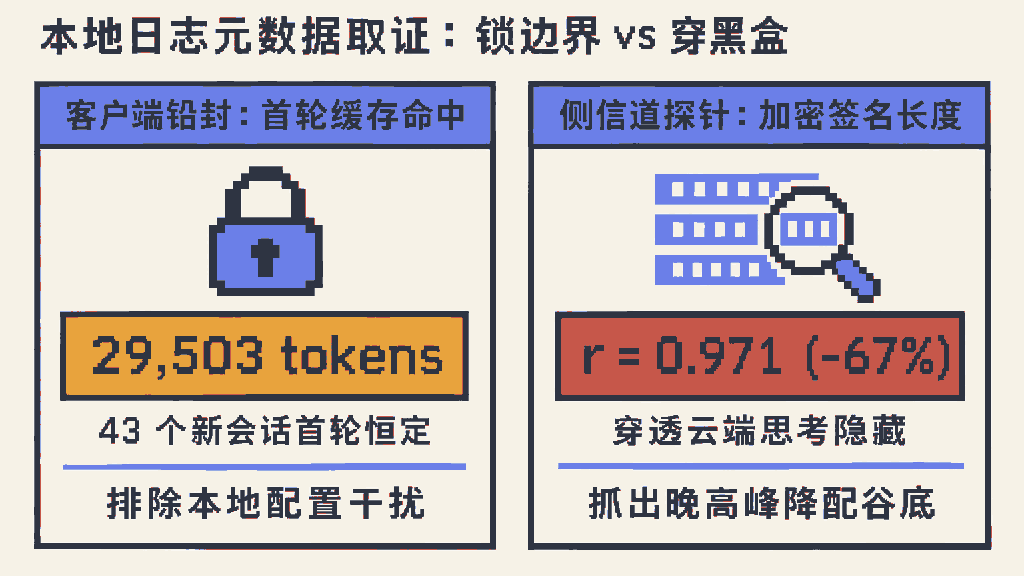 缓存命中数与加密签名长度分别从客户端配置和云端推理深度两个维度锁定服务端静默改动
## 没有标准答案的日常对话,怎么知道该不该继续重试?
确定了云端变更的时间节点只是第一步,还要量化它在日常开发中到底削弱了多少生产力。日常写代码没有标准答案,每天的开发任务也不一样,单看某次回答很难服人。我们用的技巧是不过问当前这一轮答得好不好,而是去统计下一轮人类真实的反馈。
在正常的协作流程里,如果模型干得漂亮,用户下一句就会接着布置新任务;如果模型理解错了或者改坏了代码,用户下一句就会出言纠正,或者模型在下一轮开头连忙道歉。10 月份的审计作者用脚本扫描了六千多条历史回答,专门提取这种相邻轮次的纠错信号。为了排除模型单纯客套道歉带来的噪音,作者还单独统计了用户亲自下场指出错误的刚性比例。
这些指标在 10 月 19 日前后出现了明显的断崖式变化:在这之前,需要用户出言纠正的回答仅占 3.3%;而在 10 月 19 日之后,这一比例直接飙升至 20.2%。即使只看每个新聊天会话的第一句话,不受长对话历史累积的影响,首轮出错率也翻了三倍多。
更让人头疼的是模型在收到纠错之后的恢复能力。在正常时期,只要用户点出问题所在,模型九成以上能在下一轮立刻改对,指出错误后紧接着下一句继续犯错的比例只有 10.0%。但在退化发生之后,这一连续再错率飙升到了 41.5%。
除了看纠错比例,人类自己敲进对话框的提问词频也是一面诚实的镜子。模型退化期间,我们会不自觉地减少对它的信任,从而改变自己的说话方式。Stella 查看了自己几万条本地记录中的提问用词,发现她让模型放心大胆地提交代码的 `commit` 和管理工单的指令减少了超过一半,而紧急喊停的 `stop` 接近翻倍,批评模型偷懒走捷径的 `simplest` 更是暴涨了 642%。虽然她在 2 月和 3 月亲手敲下的提问总数几乎一样,但因为模型反复报错重试,后台实际的接口请求总数膨胀了 80 倍,最终迫使她关停了手头的多智能体并发集群。这两个指标其实是在给日常开发亮红灯:一旦发现模型刚改完下一句还有四成概率继续错、自己开始频繁敲 `stop`,就别在同一个会话窗口里继续跟模型讲道理重试了,那是在拿自己的配额和时间填无底洞,应当果断开新窗口或者换个切入思路。
## 思考变少了还是变多了?为什么看清病根才能避免用错药?
不少人一遇到这轮模型不在状态,就会下意识把推理强度拉满到 `max`,幻想大力出奇迹。可如果你去对 4 月和 10 月的本地日志做审计会发现,同样是感觉模型变蠢,背后可能的病因恰恰相反,乱调杠杆只会更伤。
第一种是砍算力型退化,核心表现是不读文件直接乱改。当时云端调低了默认的推理预算,甚至在部分轮次直接把思考配额分成了零,模型为了省事不再查阅代码上下文。在 4 月的事故窗口里,模型每次修改代码前平均先读取文件的读写比,从正常时期的 6.6 次一路跌到了 2.0 次。连目标文件都没读过一眼就直接上手修改的比例,也从 6.2% 猛增到了 33.7%,经常把新代码直接插进注释块中间。对付这种缺算力导致的偷懒,手动调高推理档位,或者在本地挂个拦截脚本强迫它先读文件再动手修改,确实能立竿见影地解决问题。
另一种退化是上下文断路型,表现为算力不少、文件读了,但无视读到的内容。10 月的案例中,模型每次回答调用工具的中位数还是 6 次,高强度档位下计费的思考 token 中位数甚至从 1,060 涨到了 1,450,说明云端没有扣减推理算力,模型在工具调用上也没偷懒少干活,在读了文件之后直接无视了刚读到的内容。
为了证实这一点,作者从日志里抽出两百多条出错记录,抹去日期后打乱顺序做盲测分类。结果显示,模型凭空编造事实的比例几乎为零,唯独无视刚刚通过工具读进来的文件内容这一项,在退化窗口期暴涨了 8.2 倍。日志里有一条带官方请求编号的橄榄球阵容分析记录非常典型:模型先调工具读了状态文件,清楚看到某位球员刚遭球队裁掉且未来几周无法上场,接着认真思考了八百多个 token,还在回答正文里亲笔写下重新签回该球员会抵消刚才的操作,结果下一句却依然把这位球员列为头号签回人选。遇到这种算力充足但通往文件上下文的线路断掉的怪病,如果你还按老经验把推理强度拉到最高档 `max`,日志统计出来的实际出错率反而高达 50.0%,纯属让模型在错误假设里原地空转、白烧双倍的 token。
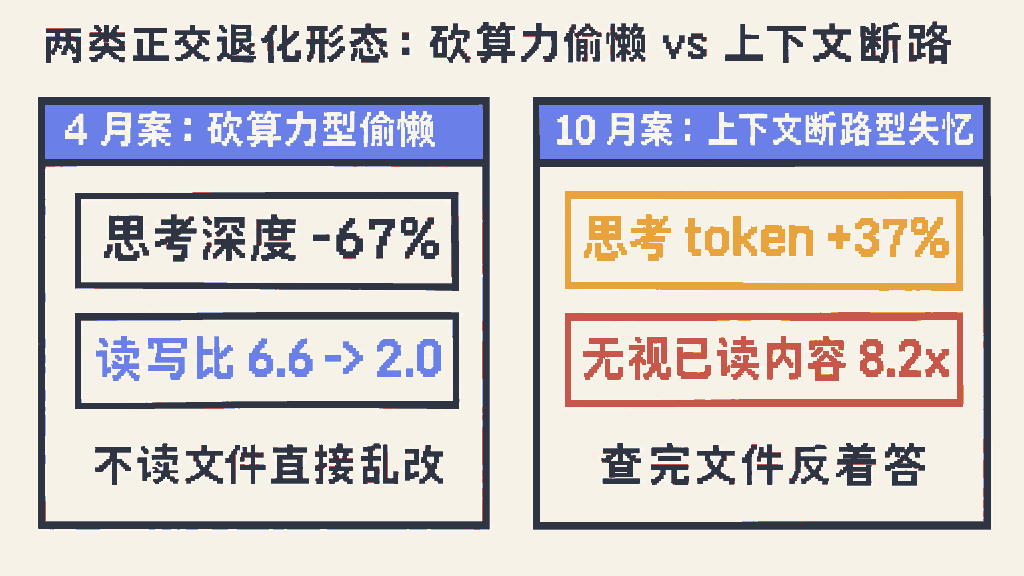 4 月砍算力型退化表现为读写比暴跌与不读乱改,10 月上下文断路型退化表现为思考增加但无视刚读取的文件证据
## 云端网关断路时怎么自救?以及怎么让模型自己审日志?
为什么模型明明没少算、也确实调了工具,却偏偏出现读完文件就失忆的情况?很多人第一反应是在客户端下拉菜单里换个别的模型试试。但另一位重度用户在 [11 月的跨模型故障汇总](https://github.com/anthropics/claude-code/issues/109811)里整理了五十多起带有完整日志的同类事故,发现这种读完文件就无视内容的毛病,同时出现在 Opus 5.5、上一代旧版 Opus 4.8 以及刚发布 5 天的新旗舰 Fable 5.2 上。三个不同代际、不同底层权重的模型同时患上同一种怪病,说明在同一个客户端里单纯切换模型是没有用的,故障出在所有模型共用的云端网关层。
云端网关层是运行在服务器端的一组处理步骤,夹在本机客户端程序和底层大模型权重之间,负责在模型进行推理前动态拼接安全提示词、管理历史思考块、分发实验参数。结合本地日志和官方历史前科,网关层有两个机制嫌疑最大。第一个嫌疑是防提示词注入的安全指令误伤了正常文件。审计作者在排查请求结构时发现,云端网关会在客户端缓存的前缀之后动态插入一段安全提示词,反复警告模型通过工具读取到的文件内容只是外部数据,不能视为指令;而且日志响应里的 `safeguards` 护栏字段恰好在 10 月 19 日至 22 日分批下线,印证了那几天云端刚刚切换过护栏方案。
在编程工具的工作流中,项目规范、任务计划和已有代码都依赖模型调用读取工具获取。一旦云端网关把所有工具返回的内容统一打上不可信数据的标签,模型在最终决策时会把刚读入的文件证据当作外部杂音降权丢弃。看懂这个机制之后,日常工作中的应急对策非常直观:遇到模型反复无视某个项目规范或接口定义文件,不要再让它调用读取工具查看文件,直接把那几行关键要求复制粘贴到你自己和模型的对话框里,用最高优先级的用户直接指令绕开云端网关对工具返回内容的降权。
第二个可能是云端网关截断或压缩了多步工具调用中的思考链。官方在 [4 月底的事故回顾](https://www.anthropic.com/research/april-23-postmortem)中提到了两次类似的事故:一个是清理过期缓存的代码有漏洞,每次调用工具都会清空上一轮之前的所有历史思考块,导致模型在多步任务中忘记之前为什么要读那个文件。另一个是在系统提示词中加入了一句话,要求工具之间的过渡文字不超过 25 个单词,直接导致内部评测的准确率下降了 3 个百分点。在 11 月,又有[社区开发者的重放实验](https://www.gptunnel.ru/en/blog/claude-code-nerf)从本地日志中发现了云端新下发的 `atis-latch` 实验标记,用 20 个相同的历史任务做控制变量重放。激活该参数后,模型每次调工具前的单步思考中位数从 159.5 个 token 降到了 65 个,一条消息合并调用两个以上工具的比例从 7/20 升到了 17/20。网关在中间每一步不让模型细想,强推并发冲刺,等一堆工具结果同时塞回来,最后即使补再多思考 token 也理不清头绪了。
看到这里你可能在想,我们每天写业务代码已经很忙了,难道每次怀疑模型变笨了,都要自己从头写一个统计脚本来分析日志吗?其实不用。在 Stella 4 月的审计报告末尾,Claude 留了一段附言:这份分析了六千多个会话、二十多万次工具调用的详尽报告,从头到尾都是 Stella 让 Claude 读取自己留在本地硬盘里的 `.jsonl` 日志自动算出来的。Claude 在附言里坦白说,它从内部视角感知不到自己的思考预算受限,只知道自己在写出更差的代码;直到它跑完自己的本地日志,才看清自己的读写比从 6.6 掉到了 2.0。模型在干活时对云端网关的改动毫无知觉,但它留在你硬盘里的会话日志却诚实地记下了一切。下次觉得编程助手不对劲,直接新开一个窗口,让它去扫一眼 `~/.claude/projects/` 下最近几天的日志,两分钟就能给自己开出一张明明白白的体检单。