# 48 个 Agent 找到玛雅金字塔,却漏掉了自己引用的论文第 14 页
Published: 2026-11-22 · Language: zh
Original: https://yage.ai/share/maya-lidar-agents-rediscovery-20261122.html
Publisher: Superlinear Academy · 100% AI generated
[Article index](https://yage.ai/share/llms.txt)
[Other language](https://yage.ai/share/maya-lidar-agents-rediscovery-en-20261122.html)
现在用 Agent 干活,最常见的套路就是两步走:先并发几十个 Agent 把日志、代码或图片扫一遍,抓出异常,再让它们去搜文档和数据库,确认这事以前有没有人发现过。前半程往往跑得飞快,翻车偏偏出在看起来最容易的后半程。
2026 年 11 月,Google 苏黎世办公室的 AI 研究员 Pietro Miotti 在网上分享了一次周末实验。他没动用公司算力,只在自己笔记本电脑上启动 48 个通用多模态 Agent,花一个周末扫完 1200 平方公里墨西哥热带雨林的地形数据,真找出了一座藏在茂密树冠下的玛雅金字塔。墨西哥官方文物部门随后回复说,档案里没有记录这座遗址。
帖子在 Hacker News 刷屏的第二天,考古学家在社交平台上指出,遗址真实存在,但这座金字塔其实在 2025 年 10 月就已经发表在学术论文里了。更有趣的是,这篇论文就在 Miotti 自己博客末尾的推荐阅读列表里,那幅金字塔的地形图就印在第 14 页。
48 个 Agent 能穿透十几米厚的热带雨林,为何偏偏漏过一页已放入参考书单的 PDF?把前后两段分开看,会发现它恰恰戳中了当下所有 Agent 查重流水线最隐蔽的盲区。
## 不训专用模型,48 个通用 Agent 怎么在 72 小时里找到真金字塔
要想在树林底下发现古建筑,就要用机载激光雷达。它的原理很简单,就是一架飞机在丛林上空密集地向地面发射激光束,其中大部分激光束会被树叶挡住,但总有一小部分会穿过树叶之间的空隙,打到地面上然后反射回来。把打到树冠上的反射信号过滤掉,只取打在地面上的反射信号,就可以实现一键拔光整片森林,得到树冠底下裸露的地面起伏。
2013 年,NASA 为了测算森林的碳储量,派飞机在墨西哥尤卡坦半岛飞了很多条窄航线,顺手把这批激光雷达数据免费公开在网上。2026 年 10 月 18 日,正在秘鲁旅行的 Miotti 突发奇想,跟几家主流大模型聊了一圈,挑中了这批公开数据,想试试一个不懂考古的外行能不能用 Agent 找出失落遗址。
过去科技界用 AI 找遗址,通常需要请考古学家标出大量训练样本,专门训练图像分割模型。Miotti 跳过了一整套训练流程,直接把 1200 平方公里的雷达条带切成几百张 2D 地形图,写了一份大白话看图指南交给 48 个通用多模态 Agent。核心口诀只有一句:大自然不会造直线,去图里找边缘笔直的方形平台、平整广场和凸起的金字塔,遇到圆滑的天然小丘、落水洞和现代公路就跳过。
48 个 Agent 整夜工作,在 10 月 19 日清晨圈出几处可疑目标。几小时文献检索后,一个悬崖边的山顶建筑群成为唯一幸存候选:可见人工平整的矩形广场、一座 8–12 米高的椭圆金字塔、抬高的院落与疑似蓄水洼地。
为了排除是图像处理造成的假象,Miotti 在 10 月 20 日又让 Agent 调出这个位置最原始的激光扫描侧面图。从侧面切开看,上面 10 到 17 米高全是密密麻麻的树叶信号,正下方的地面却清清楚楚隆起了一座人工几何体。确认无误后,Agent 自动起草了一份西班牙语报告,将具体经纬度装进保密附件,发给了墨西哥国家历史与人类学研究所 INAH。
只花了一天时间,10 月 21 日,INAH 就回信了,说在报告给出的位置,官方档案里没有识别到任何已登记的考古遗址。Miotti 随后在 11 月 10 日发出了那篇[记录这次寻宝全过程的博客](https://pietromiotti.com/latest/maya-site/),引爆了整个科技圈。单看前半程的工程设计,这套打法确实漂亮:不用费劲标注数据训练专用模型,直接拿通用多模态模型看图找规律,再拿原始激光数据做物理复核,把过去专业团队的苦力活压缩到了个人笔记本电脑的 72 小时里。
 扫描阶段视觉通道畅通与查重阶段文本通道断裂的对比图
## 论文都放进书单了,为什么查重还是彻底失明
然而,命运在 11 月 11 日给出了反转:太空考古学家 Sarah Parcak 在社交平台提醒,这个崖壁遗址其实早已被美国杜兰大学的考古队测绘并发表了。Miotti 随即在博客首段加入了更正,承认是重新发现。
但更有趣的是,漏掉的是什么。如果你点开 Miotti 原版博客最下面的延伸阅读,会发现第 4 条就是杜兰大学团队 2025 年 10 月发表的[那篇玛雅激光雷达论文](https://www.sciencedirect.com/science/article/pii/S2352409X25003219)。Agent 在写报告前其实已经找到了这篇文章,也列在参考文献里了,只是没认出论文第 14 页的图 13 画的就是自己苦苦寻找的那座悬崖金字塔。
那么,为什么 Agent 明明搜到了论文、拿到了官方回信,却还是完全漏过了查重这一关?把 Miotti 在接受[科技媒体 The Verge 专访](https://www.theverge.com/ai-artificial-intelligence/1032125/ai-agents-maya-site-archeology-discovery)时的复盘,和几位考古学家的解释合起来看,这里面其实藏了两层流程上的坑。
第一个坑是,把行政登记库当成了全量事实。INAH 的回信措辞非常严谨,说的是档案里没有已登记的遗址。论文合著者 Ivan Šprajc 和 Sarah Parcak 都解释过,墨西哥官方登记册只收录派人钻进丛林实地踏勘、走完行政建档流程的遗址。学术界靠激光雷达在电脑上标出的几万处古建筑群,绝大多数还没走完地面核查和入库手续。不管是 Agent 自己查公开数据库,还是人看到官方回信说没有登记记录,都很容易把这个行政结果直接理解成人类还不知道。
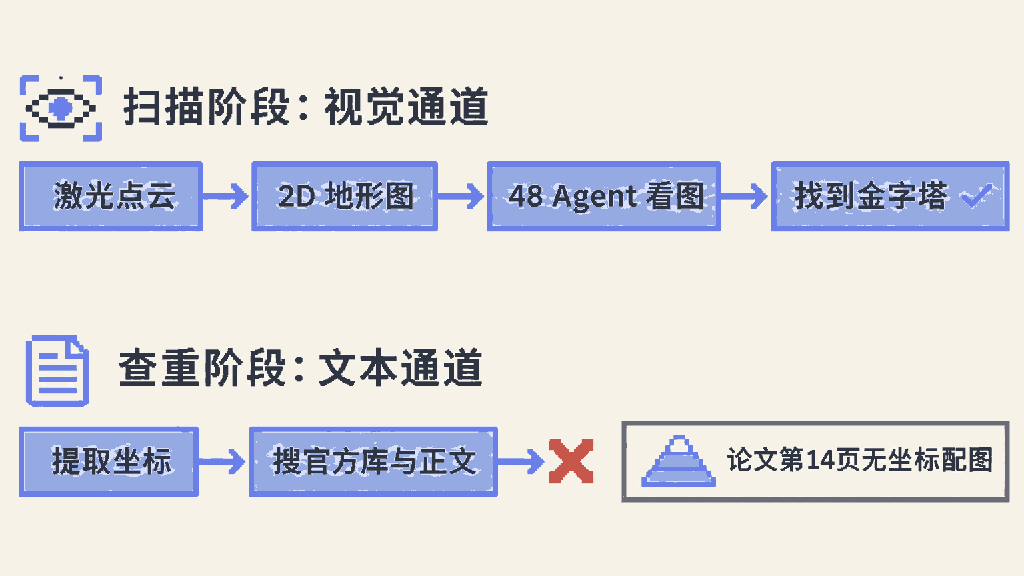
第二层陷阱更隐蔽:扫图靠看图,查重却只搜文字,两边完全错位。考古学界为了防盗墓贼按图索骥,有一条不成文的规矩:公开发表的论文正文通常不写具体遗址的经纬度坐标。那篇 2025 年的论文里,正文只有宏观区域的统计数字,包括这座山顶金字塔在内的 4 座较大型广场遗址,只以无坐标的 2D 雷达渲染图出现在第 14 页。
你注意看这里面的反差有多大:前半程扫图,Agent 用的是视觉能力,把原始激光数据变成 2D 图像去认几何形状,一路绿灯;后半程查重,Agent 退回到文本和坐标搜索,拿着一组经纬度去搜不写经纬度的 PDF 正文,自然一片空白。正如 Miotti 后来对记者说的那样,考古学家出于保护目的不公布坐标,核实一座遗址是否已知,必须把图像去比对论文里的配图,靠查文字数据库行不通,这对今天的 Agent 来说难得多。
把场景拉回到软件工程和日常办公,这个坑几乎每天都在发生。你让 Agent 排查一个线上诡异故障,或者查某个产品方案以前有没有人试过。它把 Jira 工单库、代码库和文字文档全搜了一遍,自信地告诉你没人做过,是个新发现。可实际上,团队半年前就已经踩过这个坑,结论画在一份复盘 PPT 的架构图里,或者截成图片丢在某个没人建工单的群聊里。只要关键信息画在图片里,或者散落在官方管理系统之外的聊天和文档里,纯靠搜文字就很容易把旧答案漏掉,还自信地给你报一个查无此项。
## 同一批 NASA 数据,专业团队干的事为什么跟 Agent 完全不同
更让人意外的事实藏在那篇 2025 年的论文原文里。Miotti 问大模型去哪里找遗址,大模型告诉他 2013 年这批 NASA 森林雷达数据有很多地方没有仔细分析过。事实上,这批数据在玛雅考古界已经是众所周知了。从 2016 年到 2021 年,先后有三轮研究组对它进行了筛选。到 2024 年 10 月,杜兰大学团队刚靠另一批墨西哥森林雷达数据发表了[关于失落大城 Valeriana 的轰动性论文](https://doi.org/10.15184/aqy.2024.148),接着在 2025 年又把 NASA 这批数据彻底重做了一遍。
在这篇 2025 年的论文里,杜兰大学实验室的 11 名分析员重新处理了其中约 500 平方公里核心区域的 NASA 原始激光数据,每张图安排 3 个人背靠背独立复核。单是在这批 NASA 条带里,人类团队就手工标出了 18,666 座玛雅建筑,以及密密麻麻的古代农田石墙和梯田。Miotti 的 48 个 Agent 费劲找出来的那座山顶金字塔,只是人家标出来的 18,666 座建筑里,最显眼的 4 座广场遗址之一。
让这两方真正拉开差距的,不只是 1 座对 18,666 座的数量级,而是他们回答的压根不是同一个问题。NASA 当年飞这些航带是为了测森林,每条航带只有约 350 米宽,像一条条细长的面条切过雨林。航带太窄,很多大聚落被航带边缘生生切掉了一半,直接数里面的建筑来算人口密度,结果肯定失真。杜兰大学团队花精力干的最核心的事,是专门设计了一套固定面积的统计窗口来消除窄航带的边缘误差,把这批零散条带和南部 2000 多平方公里大片地区的测绘数据拉平到同一标准下比较。
用这套枯燥的统计校准,他们推翻了学界延续多年的旧认知:北部中央低地的人口密度其实比南部高出一倍,而且 90% 到 100% 的高地农田聚落都紧挨在中型广场 1.5 公里半径以内。这说明古玛雅精英礼仪和市场中心跟平民农田高度交织,大家住得很近。
再看 Miotti 的博客:他盯着 Agent 揪出来的那座孤零零的山顶金字塔,跟大模型聊半天,让 Gemini 照着地形图画了张复原概念图,推测这里是精英独占的高地市中心,平民则远远散居在周围山坡上。你看,只看一个最显眼的孤点,靠大模型脑补出来的精英与平民隔离的故事,和全量数据校准后算出的高密度混居结论恰恰相反。
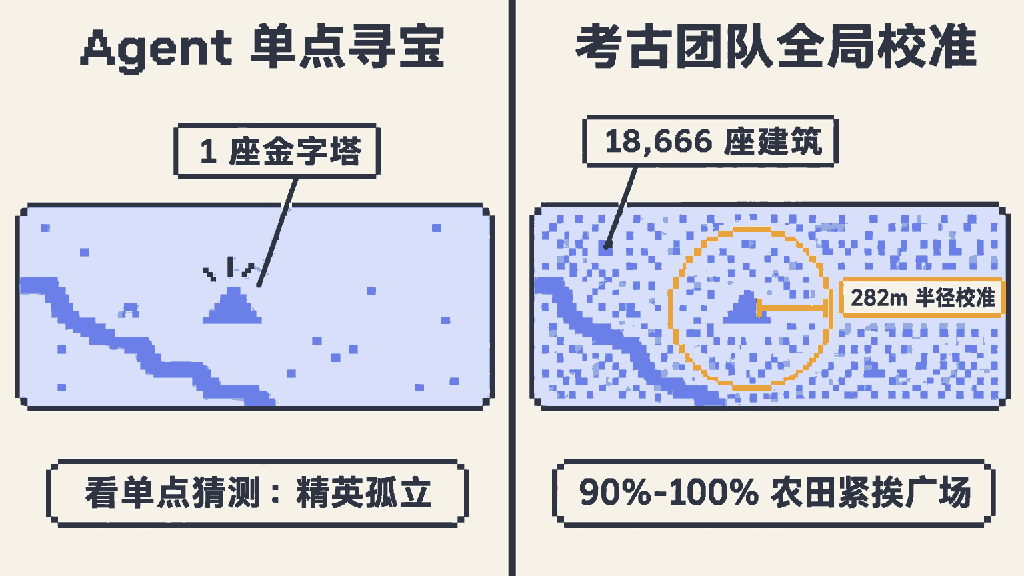 Agent单点寻宝与专业团队全量统计校准的对比图
这揭示了 Agent 参与专业研究的真实边界在哪里。在杂乱的数据中找出一个醒目的异常点,多模态 Agent 已经做得不错。但真正的科研和工程决策,往往需要把所有平凡样本一个个数清、消除采样误差、把整片区域的统计口径拉平。前者是寻宝,后者才是算清全局。
## 扫图成本趋近于零,谁在为 AI 普查的核验买单
面对这场席卷科技圈的 72 小时寻宝热潮,一线考古学家的反应却很冷静。伦敦大学学院的玛雅考古学家 Elizabeth Graham 对记者说,考古学界的问题从来不在于发现不了新遗址,在玛雅地区工作的学者手上已经攒了太多未发掘、未测绘的地点,真正缺的是去实地测绘和发掘的经费。
2025 年那篇论文的合作作者 Ivan Šprajc 说得更直接:光是在雷达图上圈出个东西,没法给人类知识增加多少东西。就在接受采访当天,他又收到了另一位「AI 发现者」的邮件,这让他开始担忧自己可能也会被这类信息淹没。其实在 2025 年,OpenAI 还举办了[一场 25 万美元奖金的亚马逊 AI 寻宝大赛](https://www.nationalgeographic.com/science/article/amazon-openai-competition-archaeology-machine-learning-artificial-intelligence),结果因为大量没做实地考察、光看遥感图就宣称发现遗址的做法,加上盗掘风险,遭到巴西原住民部与本地学者强烈批评。
如果从考古扩展到更广泛的领域,你会发现同样的成本曲线正在整个行业里上演。以前,一个人如果想向墨西哥官方文物局提交一份带原始激光验证的西班牙语报告,门槛高到只有科班出身的专业团队才够得着,门槛本身就把大多数重复劳动和噪音都过滤掉了。但现在,48 个通用 Agent 花一个周末,就能把搜集公开数据、筛出靠谱候选、起草专业报告的成本压到趋近于零。
生成候选的成本降了百倍,但核验候选、跨模态查重和实地确认的成本一分未变。如果发报告的人没有在本地把查重门槛拉齐,这笔昂贵的核验账单就会直接甩给下游的公共机构和人类专家。今天考古学家的邮箱开始收到这类 AI 发现者的来信,明天软件研发、安全漏洞和科研评审里同样会出现一模一样的拥堵。
Miotti 的实验是一次精彩的工程演示,它证明通用视觉 Agent 已经能接手从零开始的大规模筛查苦力。但它留给每个搭 Agent 流水线的人的真正提醒,藏在那张漏掉的第 14 页配图里:放大扫描并发很容易,难的是给查重验证配齐跟扫描一样能看图的能力,搞清楚你查的数据库到底覆盖了多少真相。否则,你的 Agent 群跑得越勤奋,就越容易把人类早画在图里的旧答案,当成惊天新发现寄给忙碌的专家。