# 实时语音 agent 的架构地图:两个选择和一层委派
Published: 2026-10-27 · Language: zh
Original: https://yage.ai/share/realtime-voice-agent-architecture-map-20261027.html
Publisher: Superlinear Academy · 100% AI generated
[Article index](https://yage.ai/share/llms.txt)
[Other language](https://yage.ai/share/realtime-voice-agent-architecture-map-en-20261027.html)
上周四天里,我们看到了三个公司发布实时语音产品或研究预览。其中,10月20日,Mistral推出了[Voxtral 3语音agent工具包](https://mistral.ai/news/voxtral-3/),ElevenLabs也发布了[Eleven Realtime](https://elevenlabs.io/blog/realtime)。在10月23日,Block也推出了研究模型[Dessa](https://block.xyz/dessa)。虽然这些产品都被称为实时语音产品,并且都能够在演示中实现流畅的对话,但它们的内部实现方式却各不相同。
理解这些产品之间的关系只需要问两个问题,然后再看有没有叠一层委派,也就是把马上接话和慢慢干活分给前台和后台两个模型。基于这两个问题,我们可以把市场上主要的实时语音产品归到同一个框架下。这样,工程团队在做技术选型时,不用去看各种模型排行榜,而是先问业务中最不能妥协的是什么,然后沿着这个框架倒推架构。
## 两个选择和一层委派
我们可以先用两组生活化的例子,把这两个选择讲清楚。第一组例子是传纸条和同声传译。传纸条是三个人围着长桌分工合作。第一个人听客户说话,写成纸条递给第二个人。第二个人照着纸条查资料,写好回复递给第三个人。第三个人再把纸条念进麦克风。同声传译则是译员独自坐在隔音间里,耳机里听着外语,嘴上几乎同时说出母语,一个人边听边说把话接出来。这组对照在语音系统里对应第一个选择,也就是把系统拆成几个组件,还是只用一个模型。
第二组场景是对讲机通话和饭桌聊天。两个人用对讲机说话,一人一轮。甲说完一段松开按键,对讲机发出提示音,乙听到提示音再按下按钮回话。两个人坐在饭桌旁聊天则是另一番景象。甲正在讲事情的经过,乙一边听一边点头附和,听到一半还能自然插话。这组对照对应第二个选择,也就是由谁来判断说话轮次。一种是由模型之外的组件听停顿、看语义,帮模型决定用户说完了没有。另一种是模型自己边听边说,自己决定什么时候开口、什么时候停顿或插话。这种模型自己边听边说、自己决定何时开口的方式,通常叫全双工。
如果我们把这两个选择排成一列,就可以得到一个两层的选择树。第一层是先选我们是拆成多个组件还是用一个模型。拆成多个组件就是级联,系统被分成语音转文字、大模型、语音合成三段,中间通过文字来传递。Mistral 的 Voxtral 3 是三个独立的模型串成一个流水线,开发者可以单独更换其中的大模型或声音。ElevenLabs 的 Eleven Realtime 虽然对外宣传是语音到语音的模型,但 [ElevenLabs 的兼容指南问答文档](https://elevenlabs.io/docs/eleven-agents/guides/openai-realtime-compatibility)里面写明内部也是级联的,只是组件被厂商打包了。这也说明光看产品名字是看不出架构的。级联里判断用户说完的,只能是大模型之外的组件,比如转写模型。所以这条分支到此为止。
在单模型的分支里,第二个选择是轮次由外部判断,还是模型自己判断。外部判断就是轮次式,阿里的 [Qwen3-Omni](https://huggingface.co/Qwen/Qwen3-Omni-30B-A3B-Instruct) 通常按这种方式使用,开源推理框架 SGLang 在 [SGLang 官方博客](https://www.sglang.io/blog/omni-interactive-runtime)里也把它归在这一类。由模型自己判断轮次就是原生全双工,比如 Kyutai 的 [Moshi](https://kyutai.org/blog/2024-09-18-moshi-release/)、英伟达在同一架构上做的 [PersonaPlex](https://research.nvidia.com/labs/adlr/personaplex/)、OpenBMB 的 [MiniCPM-o 4.5](https://huggingface.co/openbmb/MiniCPM-o-4_5),和 Block 的 Dessa。按 SGLang 的说法,轮次式介于原生全双工和级联之间,一个模型里集成了多模态感知和语音生成,什么时候开口、什么时候打断则由外部配置。
在原生全双工前台的基础上,可以再叠加一层委派,叫做原生前台加委派。OpenAI 的 [GPT-Live](https://openai.com/index/introducing-gpt-live/) 就是这种,前台模型每秒多次自己决定说话、继续听还是打断,遇到慢任务就交给后台。级联、轮次式、原生全双工、原生前台加委派,这四个名字都是从树上读出来的,我们后文也统一沿用。
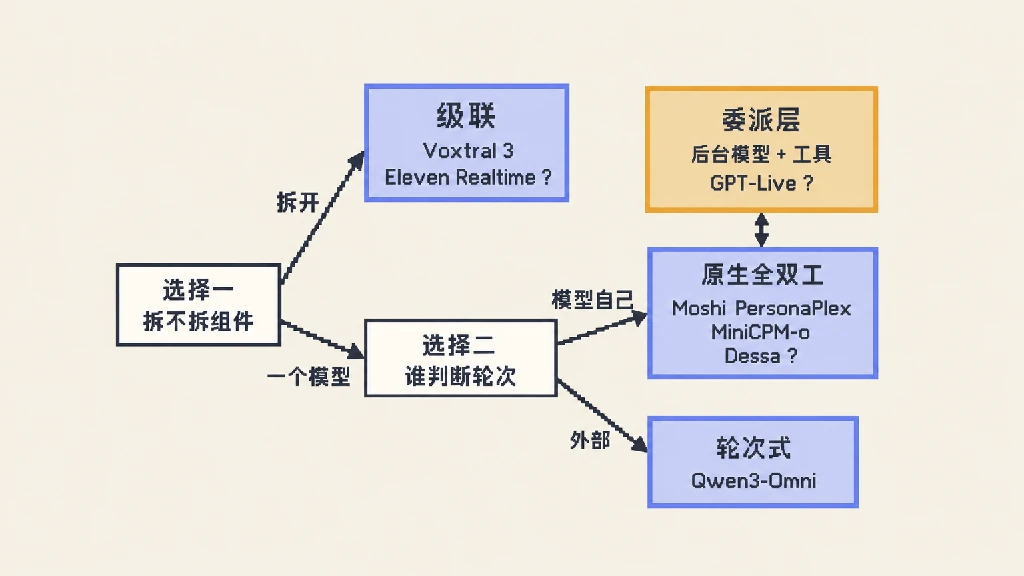 实时语音 agent 的选择树:先选拆成组件还是一个模型,拆开就是级联;一个模型再选轮次由外部判断还是模型自己判断,分出轮次式和原生全双工;原生全双工前台上还能叠一层委派
图中的问号代表官方没有披露的部分。GPT-Live 的接口会输出转写和回复的文字,但它内部是否也是先出文字再出声音,官方没有说明。Eleven Realtime 的级联中由哪个环节判断用户说完,官方没有说明,它也没有用全双工来描述自己。Dessa 目前仅有官方声明、21 段精选录音和候补名单,内部如何工作、能否接工具,官方均未说明。
## 实时性和文字,各自逼出一组取舍
看清了选择树上的分支,我们再看每条分支背后的代价。第一组取舍来自实时性。想象有人站在球台对面,每半秒朝你打来一颗乒乓球,要你当场接住打回去。你正挥着球拍,旁边又有人递来一张复杂的报税表,要你心算今年该缴多少税。只要你还得接住眼前的球,就不能停下球拍发呆十秒去算税。实时语音对话面对的就是那颗一直在飞的乒乓球。真人交谈停顿太久会冷场,前线语音模型必须在极短时间内给出声音反应。为了算得够快,模型不能做得太大,每一步也不能做漫长的多步推理,智力自然受限。[GPT-Live 官方系统卡](https://deploymentsafety.openai.com/gpt-live)印证了这一点。GPT-Live 的两个型号 GPT-Live-1 和 GPT-Live-1 mini 在多项智力评测上不如 GPT-5.5 Thinking。离开后台模型,它自己基本调不了工具,也不能执行代码。
实时性还会直接反映在账单上。实时语音会话的账单和普通文字模型的账单长得不一样。普通文字模型只在生成回复的那几秒消耗算力,用户盯着屏幕思考不花钱。但语音会话从接通到挂断全程占着计算资源,哪怕双方沉默,系统也在一直听、一直判断,所以按通话时长收费。按 [GPT-Live-1 的定价文档](https://developers.openai.com/api/docs/models/gpt-live-1),前台语音层每分钟 0.05 美元,按秒计费,每小时约 3 美元,后台模型和工具另算。单向把文字念成语音的 [Gemini 3.8 Flash TTS](https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/) 不支持实时对话和函数调用,促销期音频输出每小时约 0.81 美元。双向实时会话贵出好几倍,买的正是时刻在线的实时循环。
第二组取舍围绕文字展开。有无文字在这棵树上逐渐演变。级联分支全程依赖文字。到了单模型分支,Qwen3-Omni、Moshi、PersonaPlex 和 MiniCPM-o 4.5 等单模型内部仍有一条文字流,说话时在心里写文字。更深处,Dessa 官方声称训练时只用人类对话录音,连文字都不用。
文字越多,系统越可控。银行或电商客服最怕听错退款金额或事后查不出原因。级联中间有看得见的文字,用户说了什么、模型准备调什么工具,全程有明文记录。工程团队能查日志、能在文字进大模型前加过滤规则,也能单独换掉太贵或不够聪明的组件。代价是说话人语气里的犹豫、叹气和反讽在转成文字的那一刻就丢了大半,声音变文字再变声音也会多一层等待。反过来,越往原生全双工走,模型直接听声音回声音,对话越自然,能听懂语气并在对方换气时接话。但中间过程也越难查、越难接工具,合规留痕还得靠外挂转写补足。
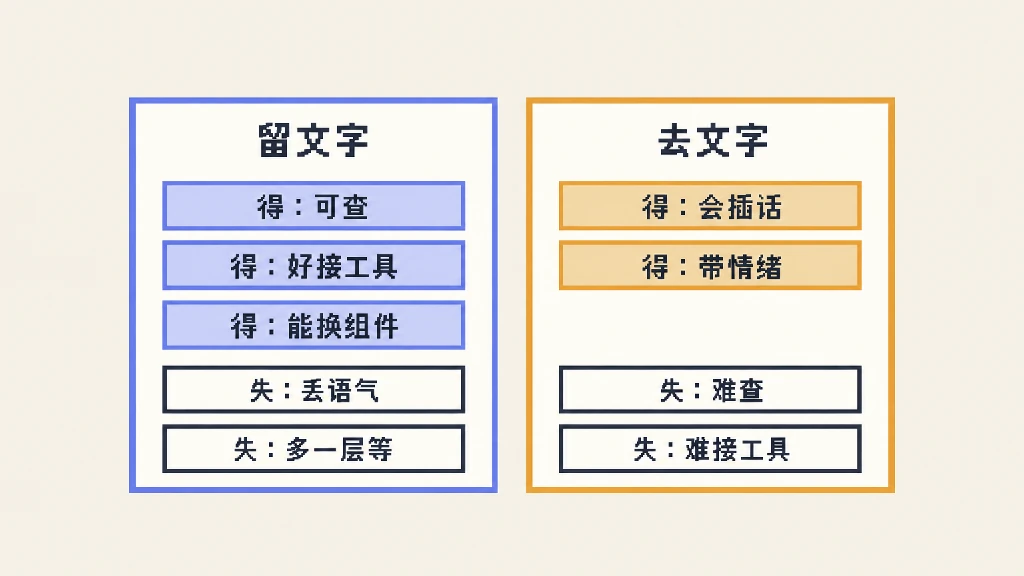 留文字换来可查、好接工具和能换组件,代价是丢语气和多一层等待;去文字换来插话和情绪,代价是难查和难接工具
而且第二个选项里面也有取舍:谁来判断轮次会影响抗干扰和打断。就算只看抗干扰和打断,树上的分支也有各自的短板。SGLang 团队做了个官方小样本自测,测试了以 MiniCPM-o 4.5 为代表的原生全双工、轮次式、级联三类抗干扰和打断的表现。在有人闲聊的背景里,原生全双工更能抗住干扰继续说下去。用户真的喊停时,轮次式和级联停得更快,但也更容易把旁人的话当成新一轮提问。原生全双工停得慢,对真打断的回应率也偏低。这次自测每组只有十到二十五条,样本很小只看方向,官方结论是没有哪种全面占优。
## 委派层:按快慢拆开交互和干活
前线语音模型为了接住乒乓球没法深思,遇到复杂的重活怎么办?设想你正在开车,拨通旅行社电话想改签一张联程机票。电话接通那一刻,你希望客服立刻应声,先回一句「好的,马上帮您查今天下午的余票,您路上注意安全」。接下来的几十秒里,客服在后台翻航司退改规定、查余票、算差价,最后再把方案报给你。接话要零点几秒的即时反应,改签要几十秒的深度推理和系统调用,两边对速度和智力的要求正好相反。把两件事塞进同一个模型,模型一思考,电话那头就冷场了。要是让轻量模型勉强去算,又常常算错差价、调错接口。
委派层就是为了解决这个快慢矛盾。它和级联的切分方式不一样。级联是按工序切,分成听、想、说三段流水线,每句话都要依次走完。委派是按快慢切,分成陪你说话的快回路和替你干活的慢回路。前台用敏捷的全双工语音模型接话,后台用擅长推理的大模型或agent干重活。
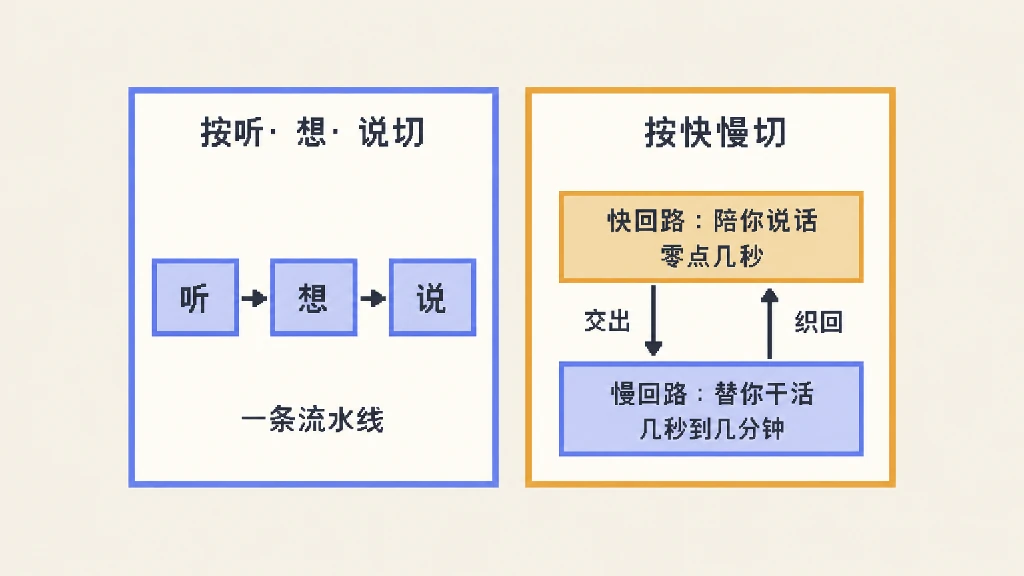 级联按听、想、说切成一条流水线,委派按快慢切成陪你说话的快回路和替你干活的慢回路,任务交出去,结果织回来
这种委派是 GPT-Live 的新意。全双工语音在 2024 年 Moshi 发布时已经有了。GPT-Live 的新意在于把全双工前台和慢思考后台做成搭档。前台维持对话,遇到搜索、推理或干活就交给后台,后台工作期间前台继续陪聊,结果就绪再织回对话。今年 9 月 [GPT-Live 的 API 发布页](https://openai.com/index/introducing-gpt-live-1-in-the-api/)上线后,委派接口已经正式开放。前台和后台之间,还站着你的应用。以改签机票为例,整个过程由三个角色配合完成。前台语音模型负责接话,决定什么时候请后台帮忙;后台模型或 agent 负责想清楚怎么改,比如查规则、算差价;需要动用你家系统的事,比如查余票、真正改订单,由你的应用执行对应的函数,应用还负责权限检查、拿到用户确认、保存任务进度。
OpenAI [实时委派的文档](https://developers.openai.com/api/docs/guides/live-delegation)里提到,建会话时可以指定两种委派模式,中途不能改。托管模式由 OpenAI 跑后台模型,你写的函数还是在你自己的应用上执行。客户端委派可以接你自己跑的任意模型或 agent。对话的转写一路推给应用;客户端委派时,前台发的委派信号本身只表示该交活了,不带原话;应用根据手上的转写和自己状态整理任务,再交给后台。后台算完后把结果交回会话,可选读出来或只进上下文。用户打断时后台可以继续,由应用决定做完还是取消。
这个交接机制也解释了文字的位置。它会丢失语音中的信息,但是它是前台对后台进行委派、后台返回结果的通用语言,而且上下文也是用文字来承载的。所以我们猜想,对于越原生、使用文字越少的模型来说,前台越自然,后台就难以接入。比如训练过程中不使用文字的 Dessa,目前还没有披露怎样给它上下文,怎样把后台的结果交回给它的机制。我们猜测后台的结果要么转换成声音的形式再喂给Dessa,要么另外开辟一个文字通道来喂给Dessa。
## 什么在变,什么不变
看清了选择树之后,在动手搭建系统之前,还需要区分哪些能力是半年内快速变化的,哪些是长期稳定的。
有三件事在快速发生。第一件是原生模型开始自己调工具。比如英伟达今年9月 [Nemotron VoiceChat 的论文](https://arxiv.org/html/2609.21967v1)展示了一个开放的全双工语音模型,模型自己就能决定调用什么工具,不用先把语音转成文字、再交给另一个模型去决定。第二件是价格。单向合成已经低于每小时一美元,我们预计双向实时会话的价格也会继续降低。第三件是判断用户说完从单纯听静音变成了结合语义来判。Voxtral 3 把它做进了转写模型里,这仍是级联内部的变化,轮次照样由大模型之外的组件判断。
同时有三件事长期不会变。第一件是无论哪种做法,用户都会中途打断,系统要停掉没播的部分,把对话记录裁到用户真正听到的地方。第二件是把重活交给更强后台的需要,只要人类几百毫秒接话的习惯不变,快慢回路的分工就会长期存在。第三件是商业场景对留痕、权限校验和可靠工具调用的要求。
理解这两点之后,我们就能在工程上做出正确的取舍:把会变的做成可替换的部分,把不变的放到自己的基础设施里。
## 从场景倒推选型
理清了取舍以及变与不变,选型就不用去榜单上找总分最高的模型,先回到场景问最不能牺牲什么。打客服电话办退款的用户,和半夜睡不着找虚拟伴侣聊天的年轻人,对好用的要求正好相反。办退款的用户能忍受客服每句话前多停半秒,但受不了退款金额搞错,或者嘴上答应退款却没发工单。找虚拟伴侣聊天的年轻人不在乎对方能不能查数据库,但只要说话像念稿子,聊两句就会关掉应用。底线不同,顺着选择树倒推的做法自然也不同。
| 如果你最不能牺牲 | 适合的做法 | 为什么 |
|:---|:---|:---|
| 把事办成、全程留痕、成本可预期 | 级联 | 中间有文字,能查、能加规则、能单独换组件 |
| 模型能直接听到语气,同时由你来控制什么时候开口和打断 | 轮次式 | 单个模型感知和发声,轮次由外部配置 |
| 说话自然、语气情绪、随时附和插话 | 原生全双工 | 模型自己判断轮次 |
| 既要对话自然,又要办复杂重活 | 原生前台加委派 | 前台接话、后台干活 |
听写这种场景,就不能用任何对话式的语音agent。[我们在七月份关于听写的文章](https://yage.ai/share/stt-contract-engineering-limits-20260731.html)里也分析过,对话式agent总是会抢答或者改写。专门的转写服务只负责把声音转成文字,不会接话。
选了分支之后,接下来要在托管和自托管之间做选择。托管整栈省事,但定制边界由平台划定。比如按 [ElevenLabs 的实时模型配置文档](https://elevenlabs.io/docs/eleven-agents/customization/realtime-models),Eleven Realtime 的组件由平台选定,Realtime 模式就不能换成自己的大模型。数据不出本地就用开放权重自己部署,可以是开源组件搭的级联,也可以是 Moshi、PersonaPlex 或采用 Apache-2.0 许可的 MiniCPM-o 4.5 这种原生全双工模型。
我们自己给两个语音入口做过选型,恰好对应了两个分支。第一个是手机上随口交代任务、边聊边让后台干活的语音助手,最不能牺牲的是自然对话和把重活交出去,所以我们选了原生前台+委派。GPT-Live 做前台用托管模式,后台模型决定哪些函数该调用,这些函数在托管模式下仍然由应用执行,因此我们在手机上执行它们,来操作我们自己部署的 agent 服务。第二个是桌面本地麦克风入口,只负责听懂指令、可靠地交任务,不需要陪聊,所以我们选了级联,中间文字可见,执行前可以加校验。同一个团队两种做法,是因为最不能牺牲的东西不同。定了架构以后,对话状态到底在哪一层,我们下一篇文章接着聊。